Nova Drive Motors
é um pipeline de dados de vendas automotivas, do PostgreSQL à visualização. Dados brutos de vendas, veículos, concessionárias e vendedores são carregados no Snowflake, transformados em camadas analíticas via dbt e orquestrados por Airflow — servindo, na ponta, um dashboard de vendas em Power BI.
Mais do que um dashboard, o projeto é um exercício de modelagem correta — entender como um dado bruto se transforma em métrica confiável, e como um erro de modelagem se propaga até o filtro que não funciona na ponta.
Objetivo
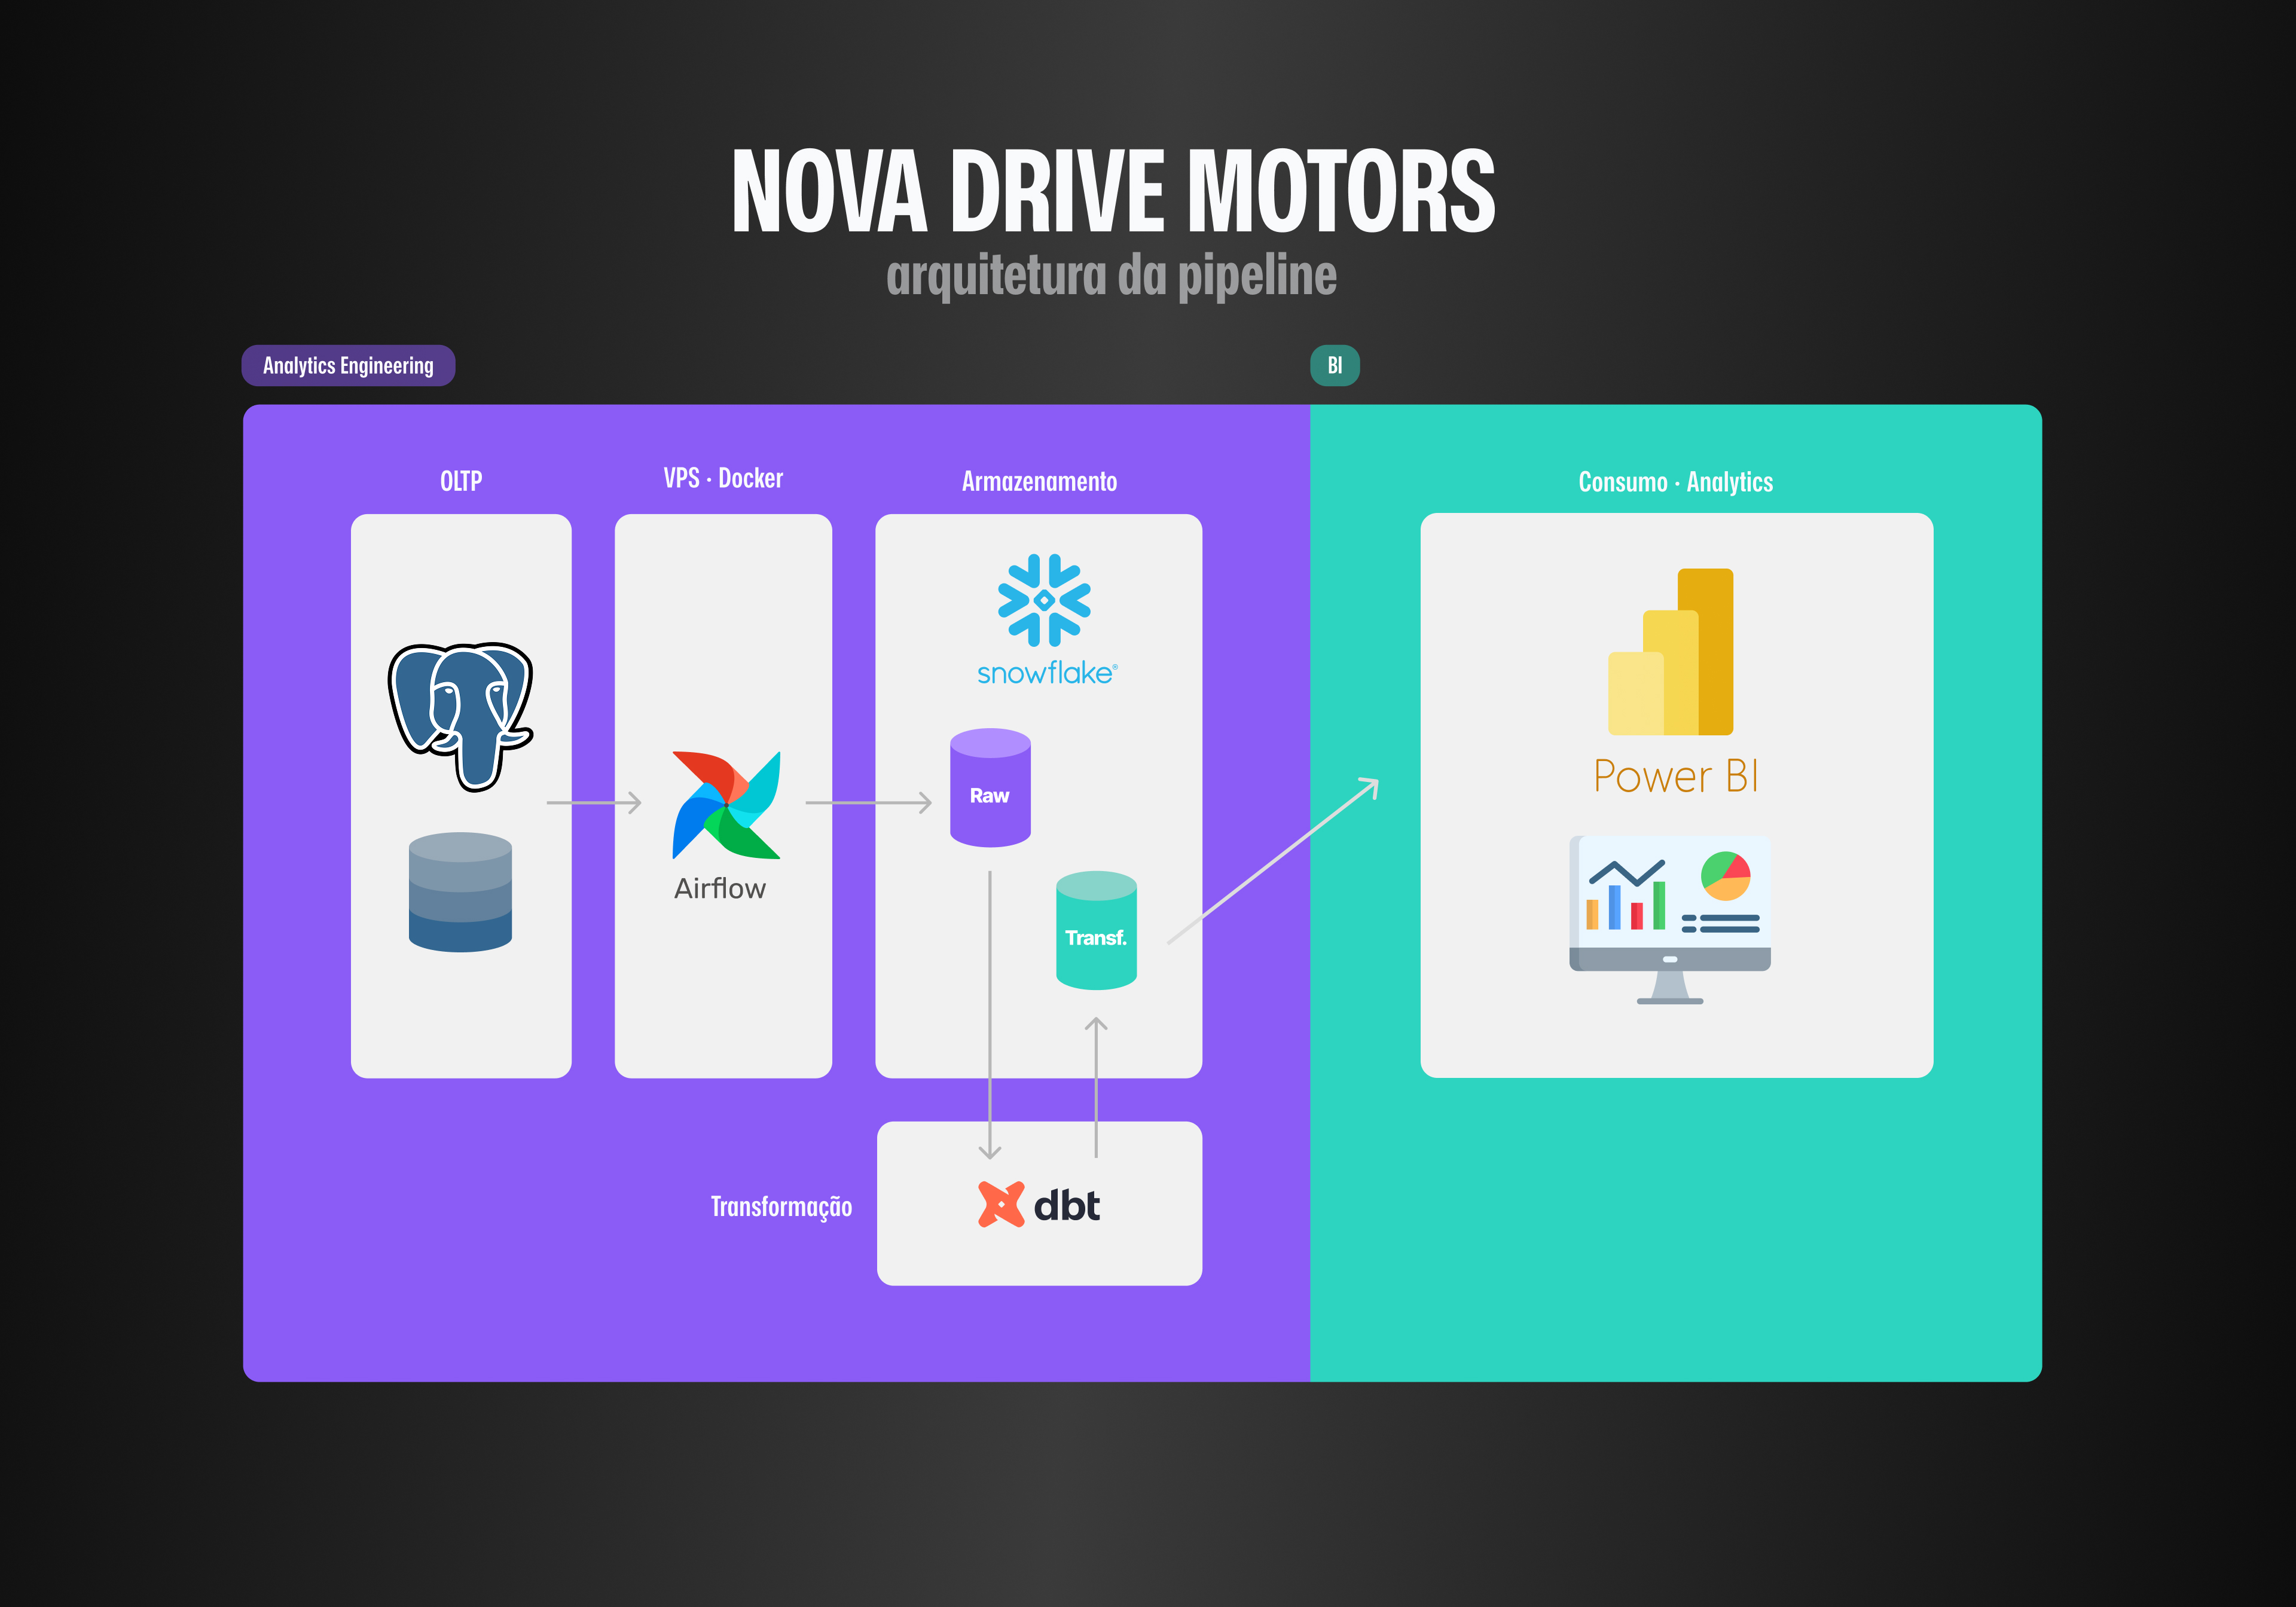
Este projeto é uma releitura do curso de pipeline de dados do professor Fernando Amaral, estruturando um pipeline de vendas — da fonte transacional (PostgreSQL) à camada analítica (Snowflake + dbt), orquestrado de forma automatizada (Airflow) e consumido por um dashboard de BI.
Duas escolhas divergem da proposta original do curso:
- Infraestrutura: no lugar da instância EC2 (usada pelo professor apenas como host Linux para o Airflow), o Airflow roda na minha própria VPS, orquestrada via Docker Swarm com Traefik como reverse proxy — reaproveitando a infraestrutura self-hosted que já mantenho para outros projetos.
- Camada de BI: no lugar do Looker Studio, usado no curso, optei por Power BI, ferramenta na qual já tenho proficiência — com análises e medidas próprias, diferentes das propostas originalmente pelo professor.
Escopo:
- Orquestração em Apache Airflow, self-hosted em VPS (Docker Swarm + Traefik)
- Modelagem em Snowflake + dbt (staging → intermediate → marts)
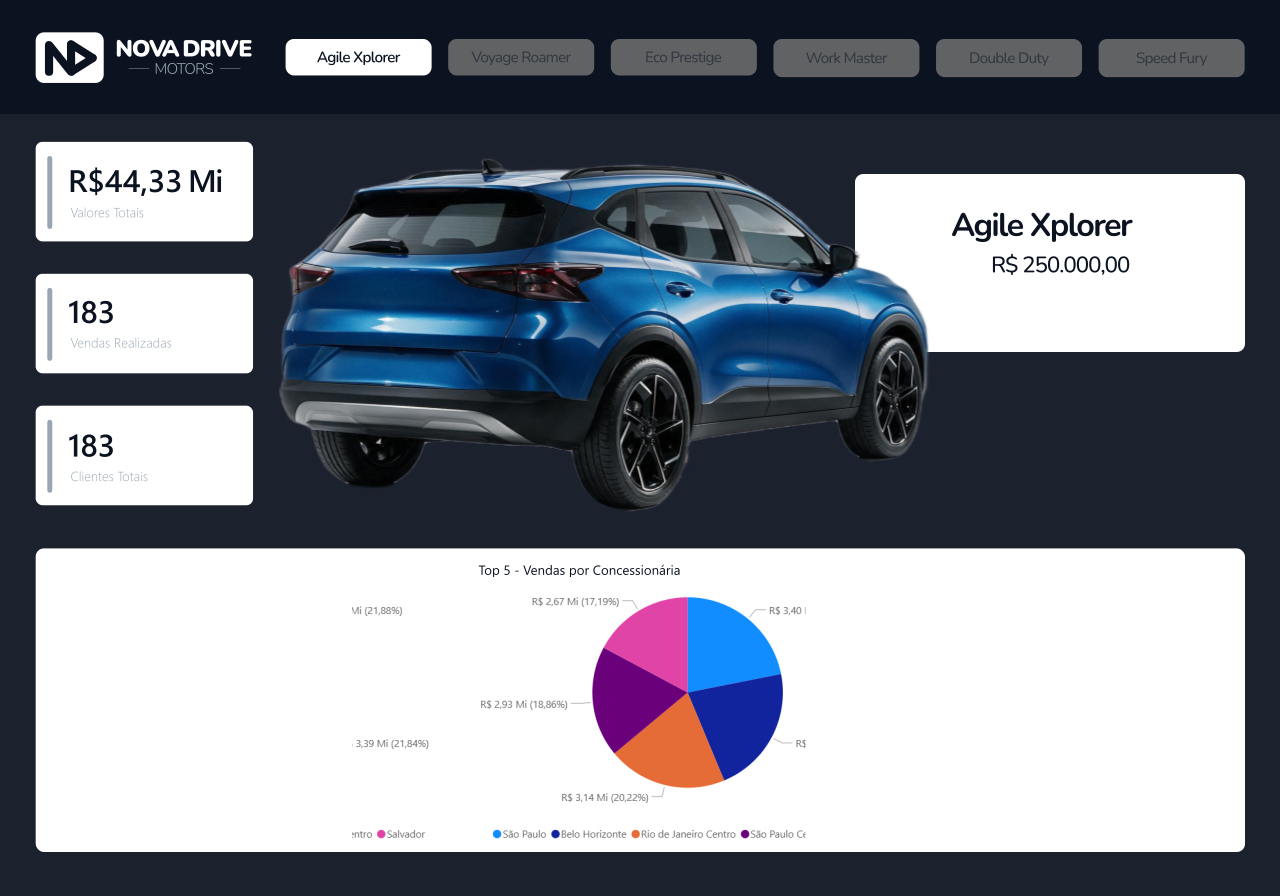
- Dashboard de vendas em Power BI, com navegação por modelo de veículo
Como Funciona
- Origem: dados transacionais de vendas (veículos, concessionárias, vendedores, clientes) armazenados em PostgreSQL.
- Carga: os dados são carregados no Snowflake, servindo como single source of truth para as transformações.
- Transformação: modelos em dbt organizam os dados em camadas (staging → intermediate → marts), resolvendo relacionamentos entre fato e dimensões e construindo as tabelas analíticas finais.
- Orquestração: Apache Airflow, self-hosted, executa e monitora o pipeline de ponta a ponta.
- Consumo: um dashboard em Power BI, com página filtrável por modelo de veículo (star schema fct_vendas + dimensões), exibe receita total, vendas realizadas, clientes totais e ranking por vendedor e concessionária.
Stack Técnica
Nota Técnica
Diagnosticando um problema de modelagem
Um ponto que vale destacar tecnicamente: a primeira versão do modelo usava tabelas de análise já pré-agregadas por dimensão (analise_vendas_veiculo, analise_vendas_vendedor, analise_vendas_concessionaria), que não compartilhavam uma chave em comum entre si — o que impedia o filtro de página (por modelo de veículo) de propagar corretamente entre os visuais. A correção envolveu voltar à granularidade da tabela fato (fct_vendas) e reconstruir o modelo estrela com as dimensões relacionadas corretamente, restaurando o filtro cruzado entre todos os visuais do dashboard.
Por que não há filtro temporal
O dataset cobre apenas 5 dias de vendas (01 a 05/08/2026), sem variação suficiente para justificar um recorte por ano, mês ou dia — um gráfico temporal com esse intervalo teria pouco valor analítico. Por isso, optei por não incluir um visual de "Vendas por Período" no dashboard, priorizando as dimensões com volume real para gerar insight (vendedor, concessionária).
Código Fonte
O pipeline completo — extração, modelagem em dbt, orquestração em Airflow — está documentado e disponível no GitHub.


